Anthropic 發表 AI 形式驗證研究安全保證仍取決於明確假設
Anthropic 與 Theorem 公開以 Claude 協助軟件形式驗證的研究,在特定 RISC-V 與 Linux 模型假設下證明程式安全性質。研究並非證明所有程式、平台或漏洞都已安全。
來源事實
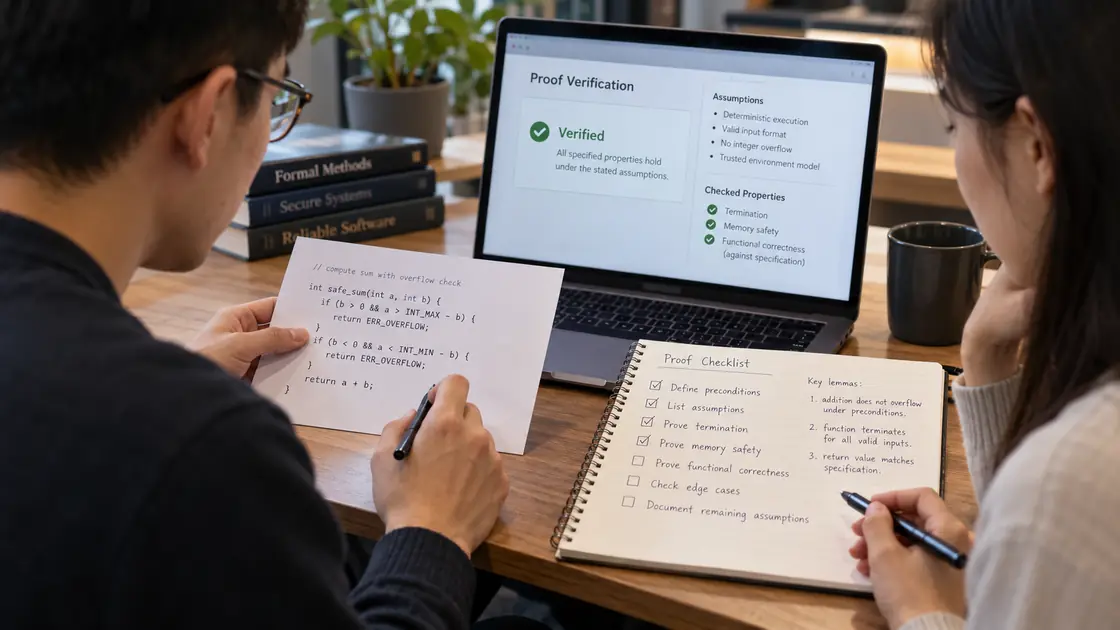
Anthropic 於 10 月 22 日介紹與 Theorem 合作的形式驗證研究,以 Claude 為多個開源程式庫建立證明,核查特定執行條件下的記憶體安全及斷言等性質。部分證明及語義模型已公開。
研究的保證有指定範圍,包括單執行緒、固定記憶體預算、RISC-V 與所建模的 Linux 行為。文章亦指出,為複雜應用程式訂出完整且明確的規格,仍是擴大驗證的重要難題。
給企業的下一步 / 編輯觀察
評估 AI 寫出的證明時,先看證明涵蓋甚麼性質、依賴甚麼假設,再決定能否用於自身部署。
原始來源
LLMs are making formal software verification feasible at a much larger scale
來源核對:2026-10-26 · SI 智能體輔助整理,未作人工逐篇審核。
本文為中文摘要與編輯觀察;來源日期與本站核對日期分開標示。原始公告如有更新,請以來源為準。
KEEP READING / 延伸閱讀


