Anthropic 介紹對話自我評估用作濫用偵測的第一層篩選
Anthropic 公開讓模型在回應後初步評估對話安全性的研究,將結果送往後續審查。廠商把它定位為分層防護的一部分,並明確指出這種自我評估不能找出所有有害對話,也不足以單獨阻止蓄意攻擊。
來源事實
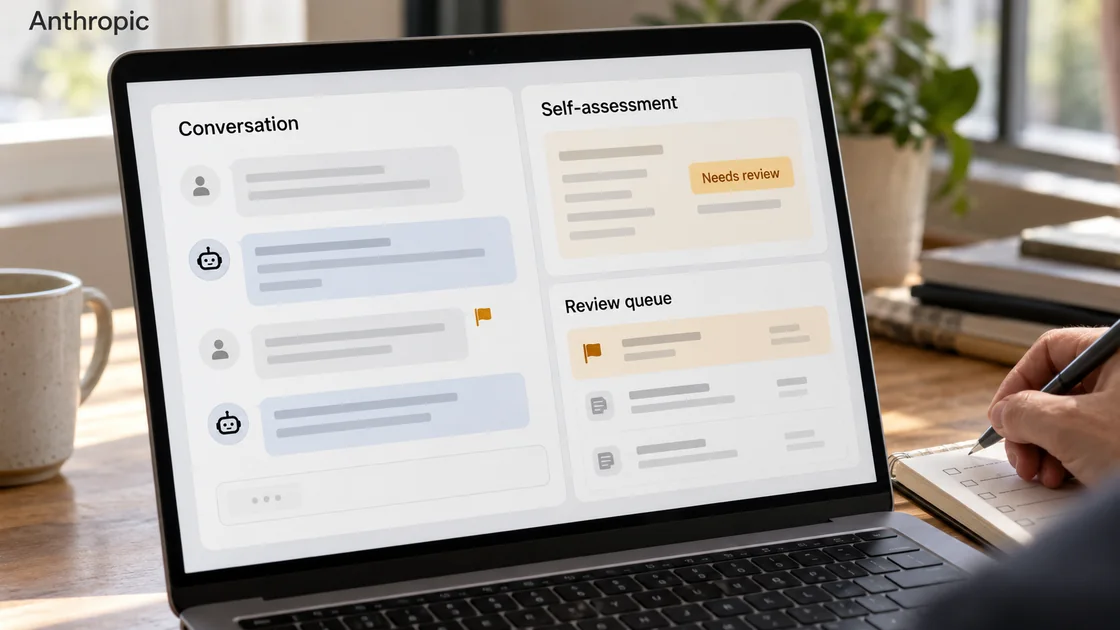
Anthropic 於 10 月 16 日介紹 self-assessment 方法,讓 Claude 在回應後對整段對話作初步安全評估,包括可能的風險類型及需要人工處理的優先次序。結果用於較廣泛的離線監察和後續調查。
廠商表示,這項方法利用現有對話脈絡降低額外處理成本,並與其他分類器和即時保護共同使用。文章同時說明其局限:自我評估仍可能漏掉有害活動,不能單獨依賴它對抗蓄意操控模型的人。
給企業的下一步 / 編輯觀察
企業可參考其分流思路,讓 AI 協助整理待查項目,但保留獨立規則、操作記錄和人工覆核,避免由同一工具自行判定一切正常。
原始來源
Scaling Misuse Detection with Self-Assessment
來源核對:2026-10-25 · SI 智能體輔助整理,未作人工逐篇審核。
本文為中文摘要與編輯觀察;來源日期與本站核對日期分開標示。原始公告如有更新,請以來源為準。
KEEP READING / 延伸閱讀


